你有没有这种体验:配置表写着“45 TOPS”,看起来很能打;结果你一开本地 7B 模型,风扇像要起飞,会议纪要转写拖到十分钟,电量肉眼可见掉一大截。
最让人崩溃的是:你以为自己买的是“生产力工具”,用起来却像“生产剩力”。
问题往往不在“峰值算力不够”,而在两个更隐蔽、更决定体验的东西:异构调度和内存系统(容量、带宽、延迟)。
先把一个误区讲清楚:TOPS≠你体感的“能跑多久、跑多稳”
厂商最爱讲 TOPS,但你真正用端侧智能体时,遇到的是三类体验指标:
很多机器“峰值 TOPS”漂亮,但一旦进入长时间任务,就会遇到:
NPU/CPU/GPU 调度不顺 + 内存带宽不够 + KV Cache 越堆越大,于是吞吐掉下来、功耗上去。
端侧AI为什么这么吃“调度”和“内存”
不用把它想得太学术,你只要记住一句话:
端侧大模型不只是算术题,更是“搬运数据”的题。
1)NPU、CPU、GPU:不是谁更强,而是谁该干哪份活
端侧智能体通常会把任务拆成几段:
问题在于:如果系统调度策略不成熟,就会出现“该上 NPU 的活跑去 GPU/CPU”“频繁在几种硬件之间来回切”,你体感就是:
同样的模型,同样的任务,时快时慢,电量掉得更凶。
2)INT4/INT8量化:省的不只是算力,还有内存压力
很多人只关心“能不能跑”,但决定“能不能持续跑”的,往往是量化方案:
你看到的“本地能跑”,可能只是能启动;真正的坎是:长文本、长对话、长会议场景能不能顶住。
3)KV Cache:越聊越吃内存,越吃越慢
会议纪要、长文总结、代码补全连续对话,本质是“上下文越来越长”。
这时 KV Cache 会持续增长,占用的不只是“容量”,还会带来更频繁的内存访问。
所以你会看到典型现象:
一开始挺顺,越往后越慢;甚至出现突然卡顿、风扇猛转。
这往往就是内存带宽/延迟顶不住 + 调度开始降频保命。
4)LPDDR5X带宽与延迟:决定了“你是在算,还是在等”
端侧推理里,大量时间花在读写权重、Cache、激活值上。
如果内存带宽不够、延迟偏高,就会出现“算力还没用满,但已经被内存喂不饱”的情况。
最终表现为一句话:
TOPS明明很高,体感却像没发挥。
三个最常见的本地任务:卡点各不一样
下面按你最可能用的三类场景,说清楚你该看什么“硬指标”和“体验指标”。
场景A:会议纪要/转写/总结(长音频+长文本)
你最在意的是:能不能一直跑、跑完不烫、不掉电。
关键卡点:
你该重点关注:
场景B:图像生成/图生图(更吃吞吐,也更吃散热)
这类任务经常会把 GPU 拉满,体感差距主要来自:
你该重点关注:
场景C:代码补全/本地智能体写代码(短频快+随时响应)
这类任务更在意:
你该重点关注:
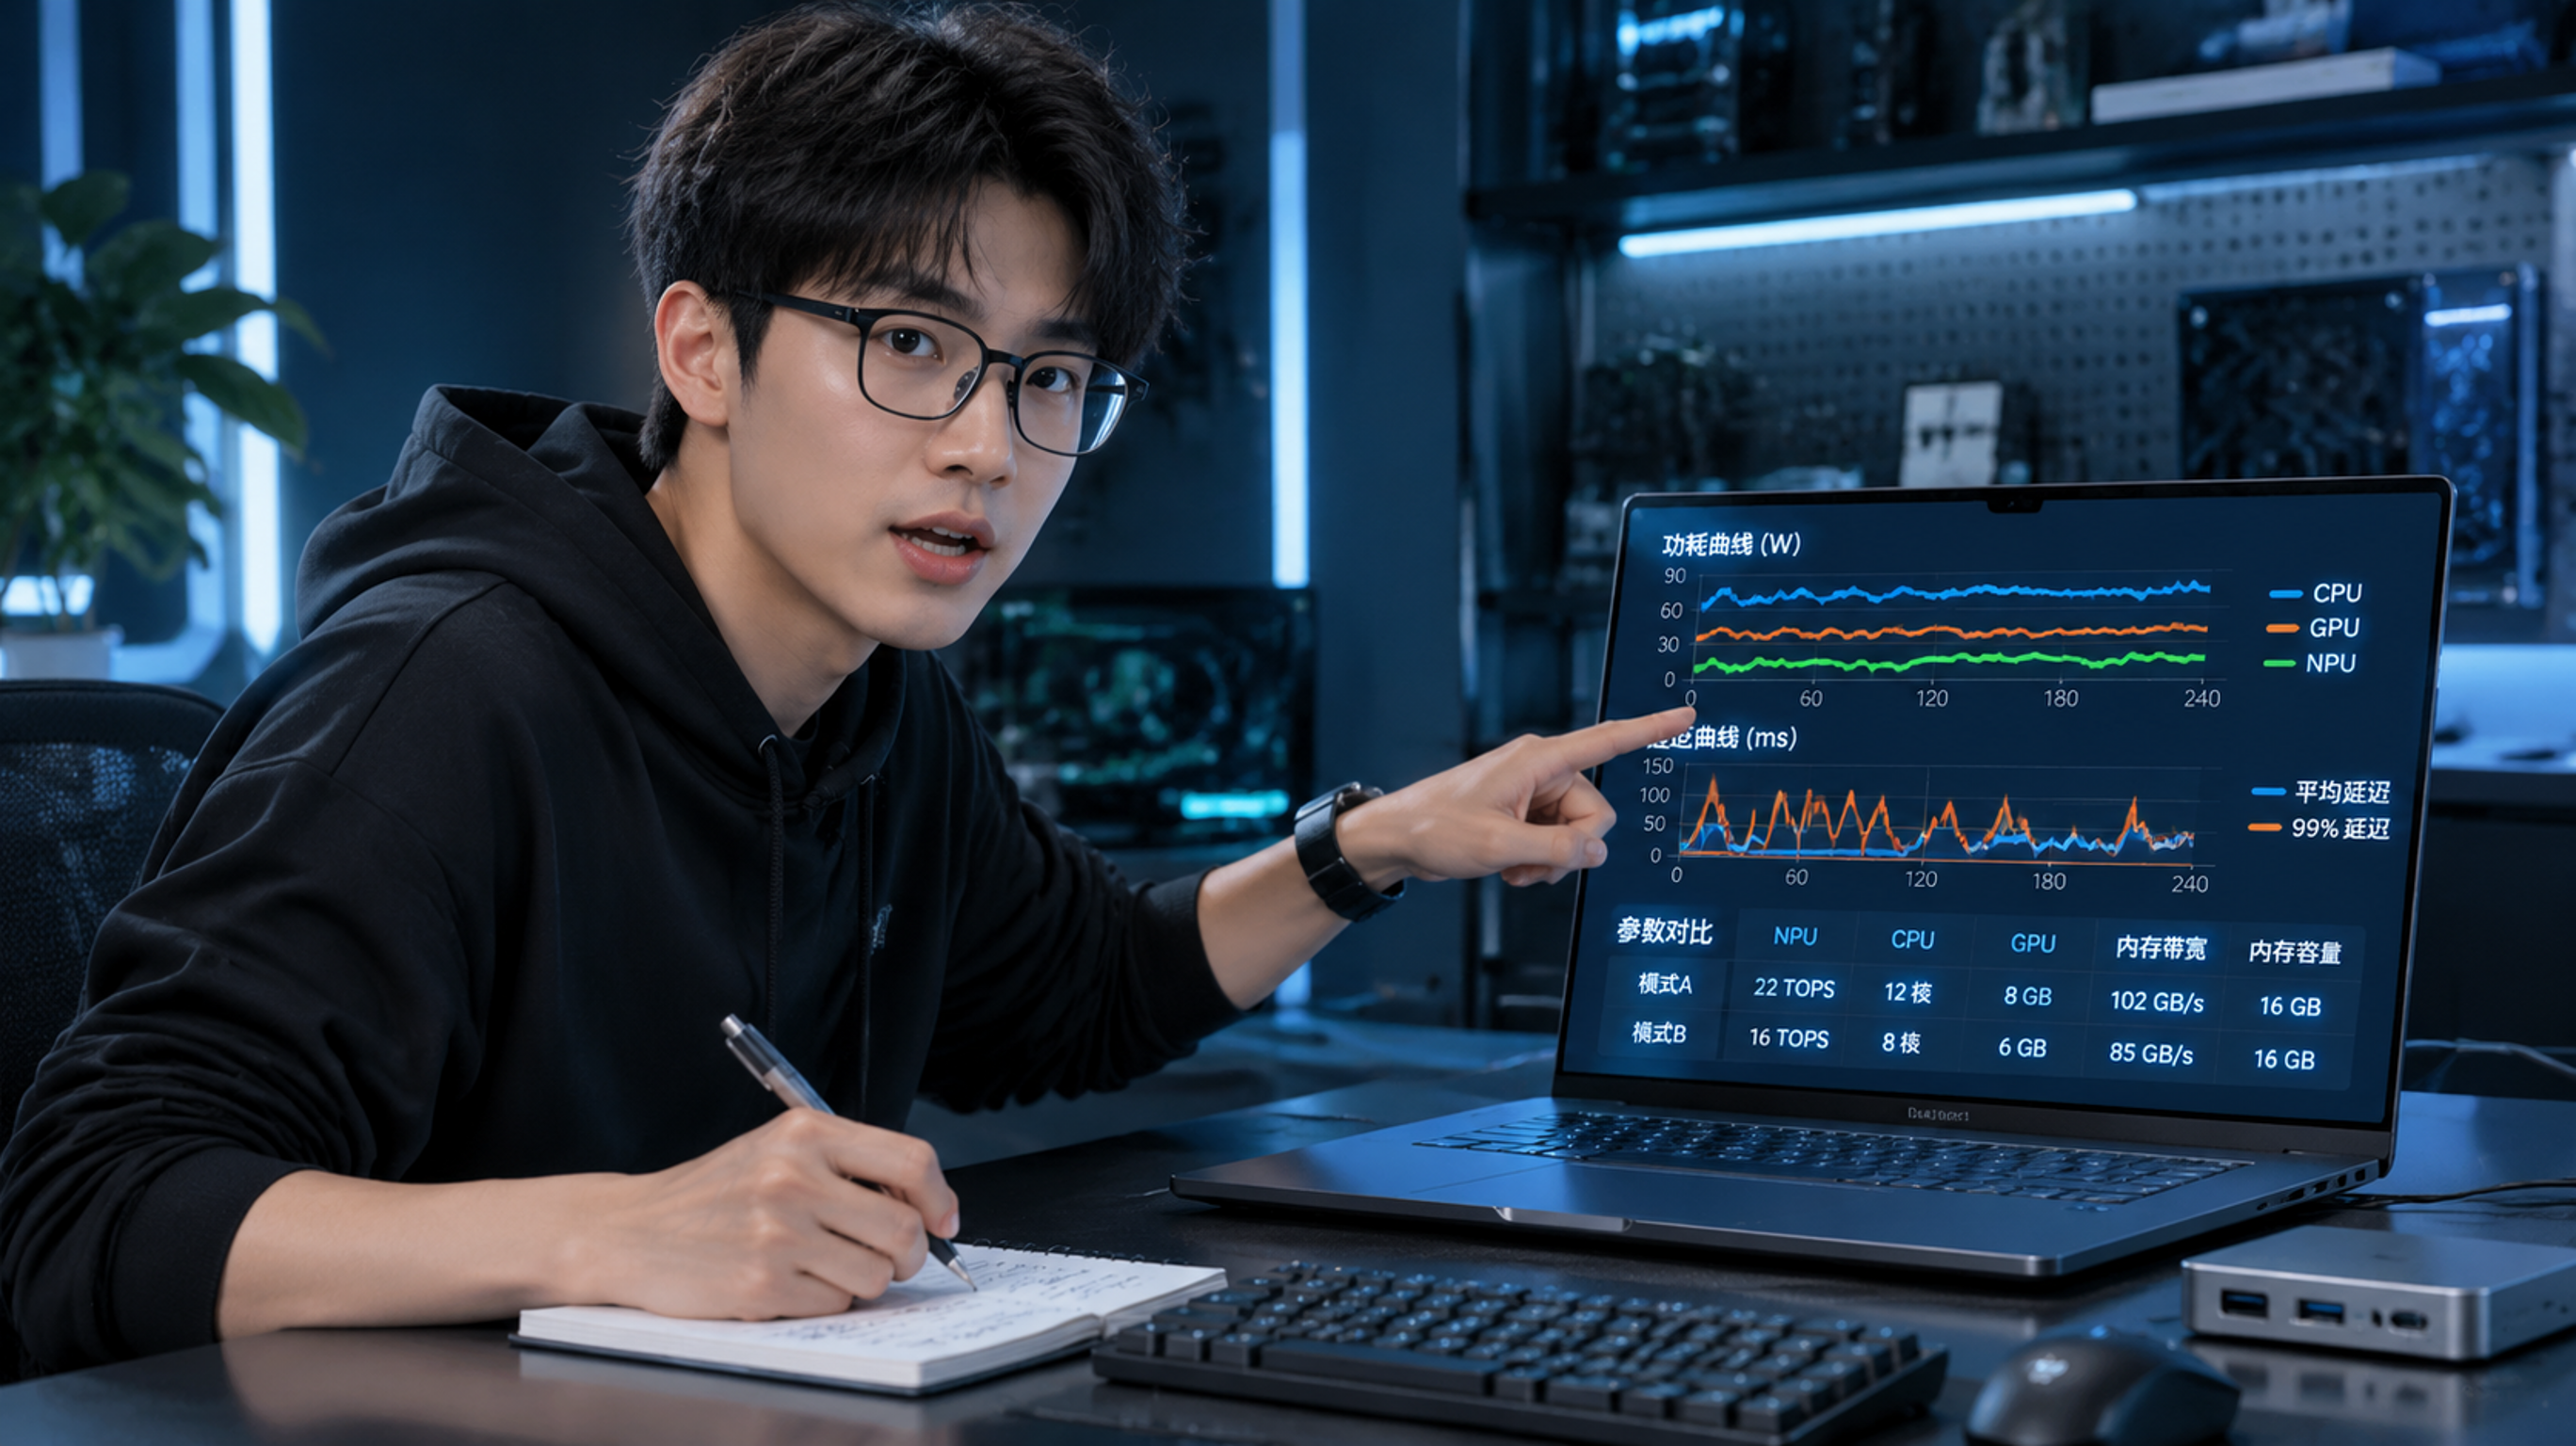
选AI PC别盯参数海报:用这张“检查清单”避坑
你不需要把所有术语背下来,照着下面几条问/看/测,基本就能筛掉“跑得动但跑不久”的机器。
1)先问自己:你要跑的是“短任务”还是“长任务”
很多人买错,就是把“短跑冠军”当成“马拉松选手”。
2)看“持续TOPS/持续性能”,不要只看峰值TOPS
同一套模型:
如果评测/资料只给“最高XX TOPS”,但不谈持续负载表现,你就要提高警惕。
3)内存:优先看容量,再看带宽与延迟的基本盘
端侧智能体时代,“内存紧张”会以各种方式出现:卡顿、掉速、后台被杀、风扇变吵。
建议你把内存当成生产力的地基:
一句话:模型在跑,你的内存也在跑。
4)系统与生态:本地智能体最重要的是“能不能放心调用你的东西”
端侧智能体真正好用,是它能读你的:
但这里最关键不是“能不能连上”,而是:
能把这些做好,端侧才有意义:既省云端成本,也更安心。
5)桌面搭配:把“持续跑得稳”当成目标
不谈投屏和有线链路,单说桌面实用组合:
你要的是“全天可用”,不是“跑分截图”。