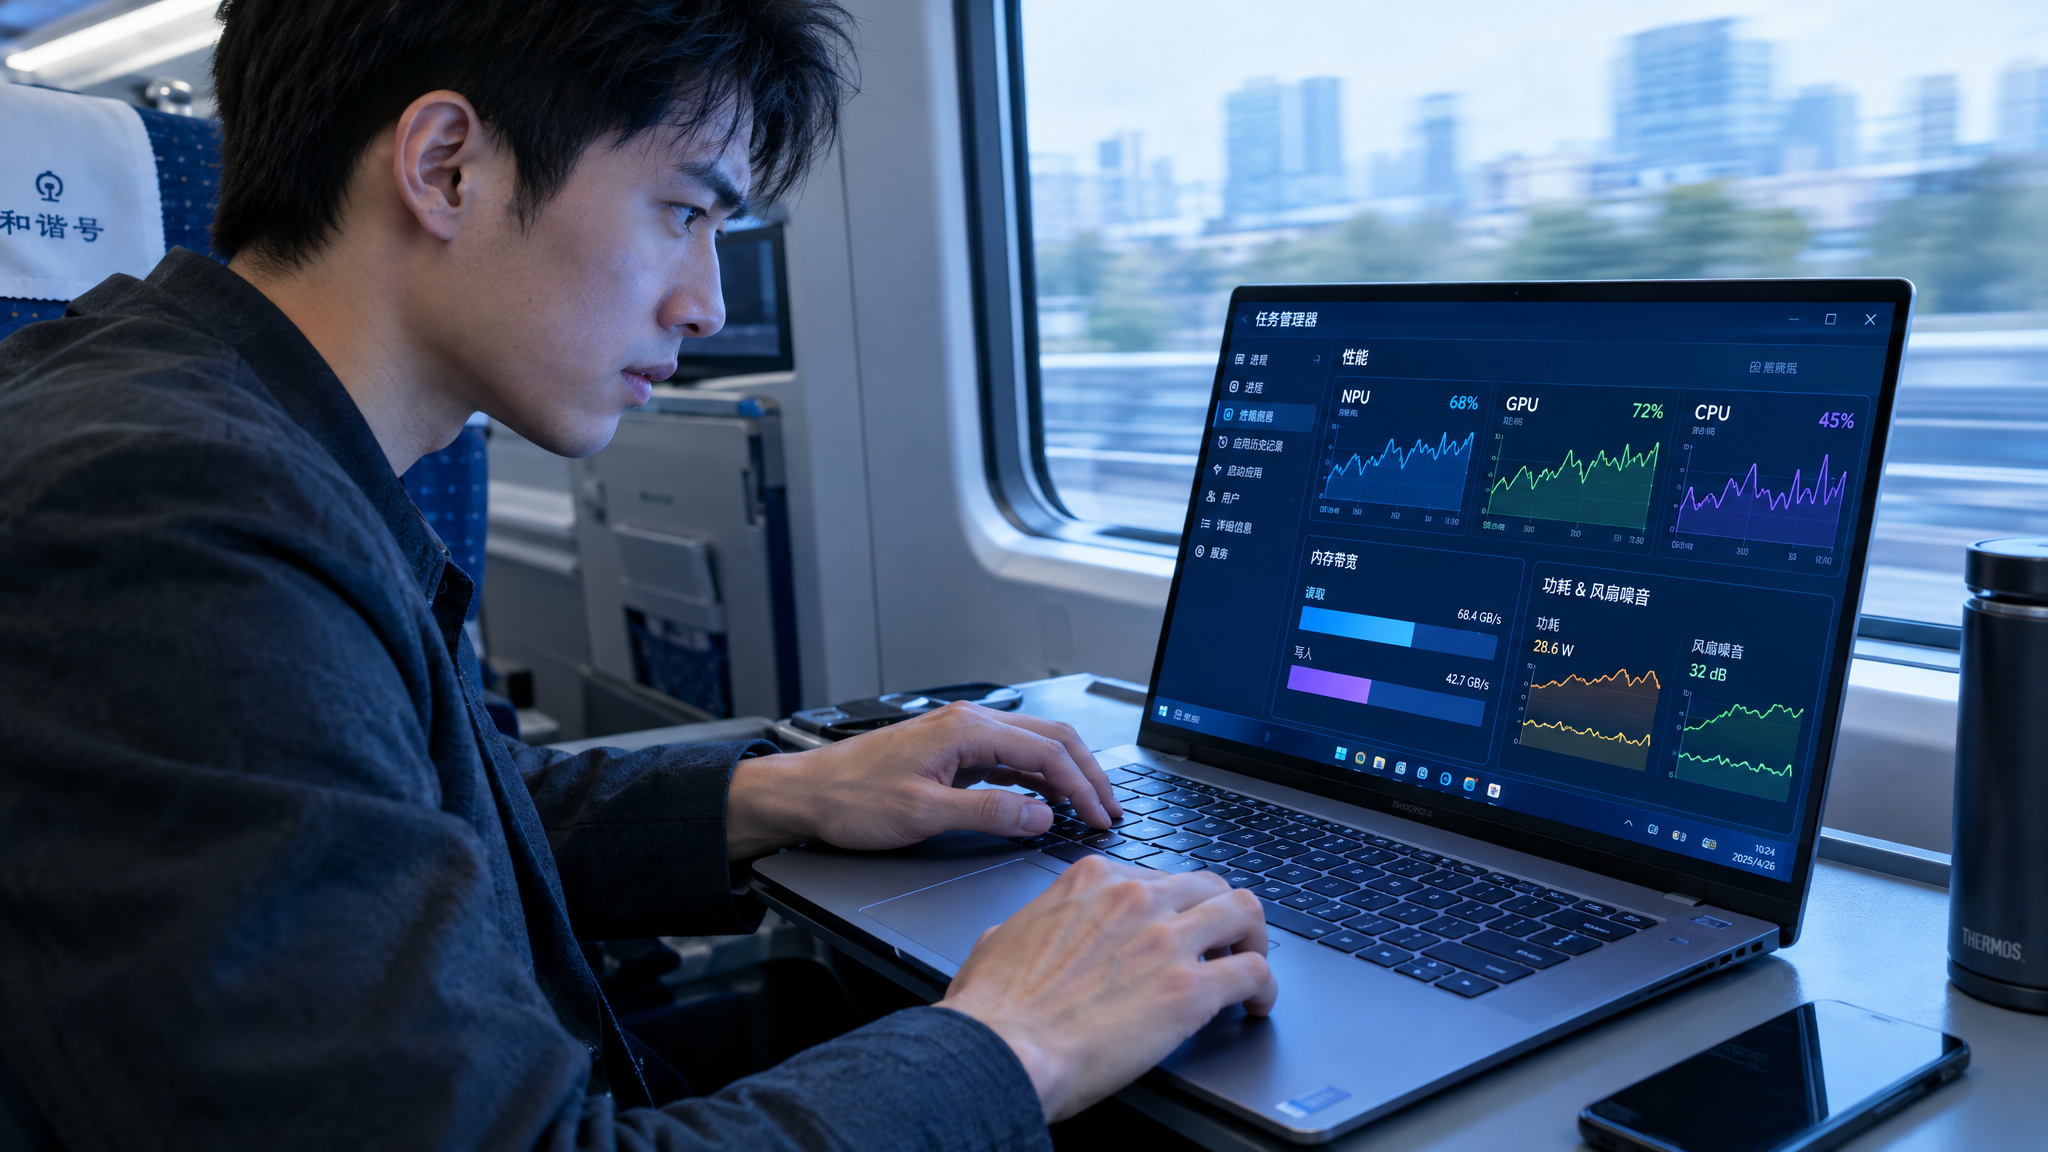
高铁上想偷个懒:把录音丢进本地14B做会议纪要,顺手开着Copilot+的本地回想。结果就是——进度圈转到怀疑人生,风扇从“图书馆模式”切到“起飞模式”,电量肉眼跳水,最后吐出来的摘要还像随机拼接。
你会下意识怪NPU:不是写着80 TOPS吗?怎么跟宣传完全不是一回事?
问题往往不在“算力够不够”,而在“数据供不供得上”。大模型不是纯计算题,它更像一场搬砖比赛:谁能更快把权重、激活、KV Cache在内存里来回搬运,谁就更流畅。
先把一个误区掰直:NPU不是用来硬刚大模型的
NPU的核心价值是:低功耗、长时在线、专门加速固定/常见的推理算子,尤其擅长 INT8/INT4、稀疏、常驻小模型那类工作。
但你本地跑14B时,最折磨人的往往是 prefill(首段“读入+理解提示词”的阶段)——这阶段非常容易被“内存带宽”卡住。
很多2026年的Windows AI PC走统一内存(LPDDR5X 8533MT/s)路线,理论带宽大约 136GB/s;而独显那边动辄是上千GB/s 的显存带宽。两者完全不是一个量级,所以你看到的体感就是:
结论很简单:你以为你在买“TOPS”,你实际在买“带宽、内存、调度成熟度”。
决定你体验的其实是三层:上限、能跑多长、跑得多安静
把体验拆开,会更好理解:
1)内存带宽决定上限
带宽不足时,你再高的NPU峰值也像“空转的发动机”。大模型吞吐(Token/s)和首Token延迟都会被拖慢。
2)KV Cache容量决定你能开多长上下文
同一个14B模型,你开更长上下文、开更多并发,就会吃更多内存。内存紧张时就会频繁挤占、交换,体感就是卡顿和掉速。
3)NPU/GPU/CPU调度决定功耗与噪音
Windows ML 以及各家的 Execution Provider 在 NPU 和 iGPU 间切分算子时,只要遇到 NPU 不支持的算子,就可能回落到 CPU。CPU一接管,常见结果就是:速度下滑、功耗上升、风扇拉满。
所以别再盯着“80 TOPS / 100 TOPS”这种单一数字了:它不能回答你最关心的两个问题——首Token多久到、稳定输出有多快。
三步给AI PC参数“去水分”:别再只看TOPS
1)先问清楚:你看到的TOPS是不是“稀疏INT4峰值”
很多标称TOPS来自稀疏 INT4 的峰值场景;而你真实跑模型,可能是稠密计算、混合精度、动态shape,实际吞吐往往差好几倍。
看不懂也没关系,你只需要记住一句:
只报“峰值TOPS”,不报真实延迟与吞吐的,参考价值非常有限。
2)再看内存:16GB与32GB不是“差一点”,是“两种人生”
如果你想比较舒服地本地跑14B(尤其还想开更长上下文),32GB LPDDR5X基本是门槛。
16GB更像是:7B量化体验区,能跑,但别指望多优雅。
同时别忽略带宽:统一内存就意味着CPU/GPU/NPU都在抢同一条“水管”。水管越细,大家越容易互相拖累。
3)最后看NPU能力:混合精度与动态shape支持很关键
同样是“有NPU”,差别可能在于:
这决定你是不是经常看到“突然变卡、风扇突然起飞”。
一套最直观的实测指标:4个数字,直接打掉玄学
想让评测/自测有意义,别再问“它多少TOPS”,请统一看这四项(同模型、同prompt、同设置):
1)首Token延迟:从点发送到第一个字出现要多久
2)稳态Token/s:稳定输出时每秒多少token
3)整机功耗:同样速度下谁更省电
4)风扇噪音:同样任务下谁更安静
任何只给你一串TOPS、却不愿意给这四项数据的内容,基本可以直接划走——因为它没回答你真正的使用体验。
2026年更顺手的“分工策略”:让NPU干它最擅长的活
如果你希望移动办公别变“暖手宝”,一个实用的分工是:
比如实时字幕、会议降噪、摄像头背景虚化、唤醒词这类
比如生图、视频剪辑、需要更高带宽/并行度的阶段
让它保持“灵活”,别让它被迫长期扛大模型推理
还有一个很反直觉但很有效的设置:
电源模式优先用“平衡”,不要上来就“高性能”。很多情况下这反而能让NPU接管更多合适的负载,续航能多出 1 到 2 小时,同时噪音更可控。
移动与桌面两种场景的正确打开方式
把外设与存储扩展起来,减少“什么都挤在一台轻薄本里”的资源争抢,整体体验更稳定。
真要在高铁、机场跑本地大模型,别硬扛“高精度+长上下文”。把目标改成“够用、稳定、省电”,才是2026年AI PC更现实的赢法。