最难受的是:你明明是想“离线提高生产力”,最后变成“离线消耗耐心”。
问题往往不在你不会用,也不在“你机器不够新”,而是很多人选 AI PC 时盯着 TOPS,却忽略了真正决定体验的三件事:异构调度、统一内存(容量+带宽)、量化格式。
1 个误区:TOPS 是入场券,不是通行证
TOPS 更像“这个平台有没有资格做 AI”的门槛指标。到了 2026 新一波 Windows AI PC 平台,NPU 确实更强了,但你跑本地大模型时,真正的瓶颈经常出现在这条链路里:
你看到的卡顿,常见不是“算力不够”,而是:
一句话:本地大模型更像“搬运+吞吐”的游戏,TOPS 只决定你能不能上桌,内存系统决定你能不能吃饱。
真正影响体感的 3 个指标:容量、带宽、量化
1)内存容量:决定你能装下什么,不只是“能不能打开”
同样是“能跑模型”,16GB、32GB 与更大容量档位的差别通常体现在:
如果你的目标是“常驻离线助手”,容量不足会让你永远在做取舍:关软件、缩上下文、降模型。
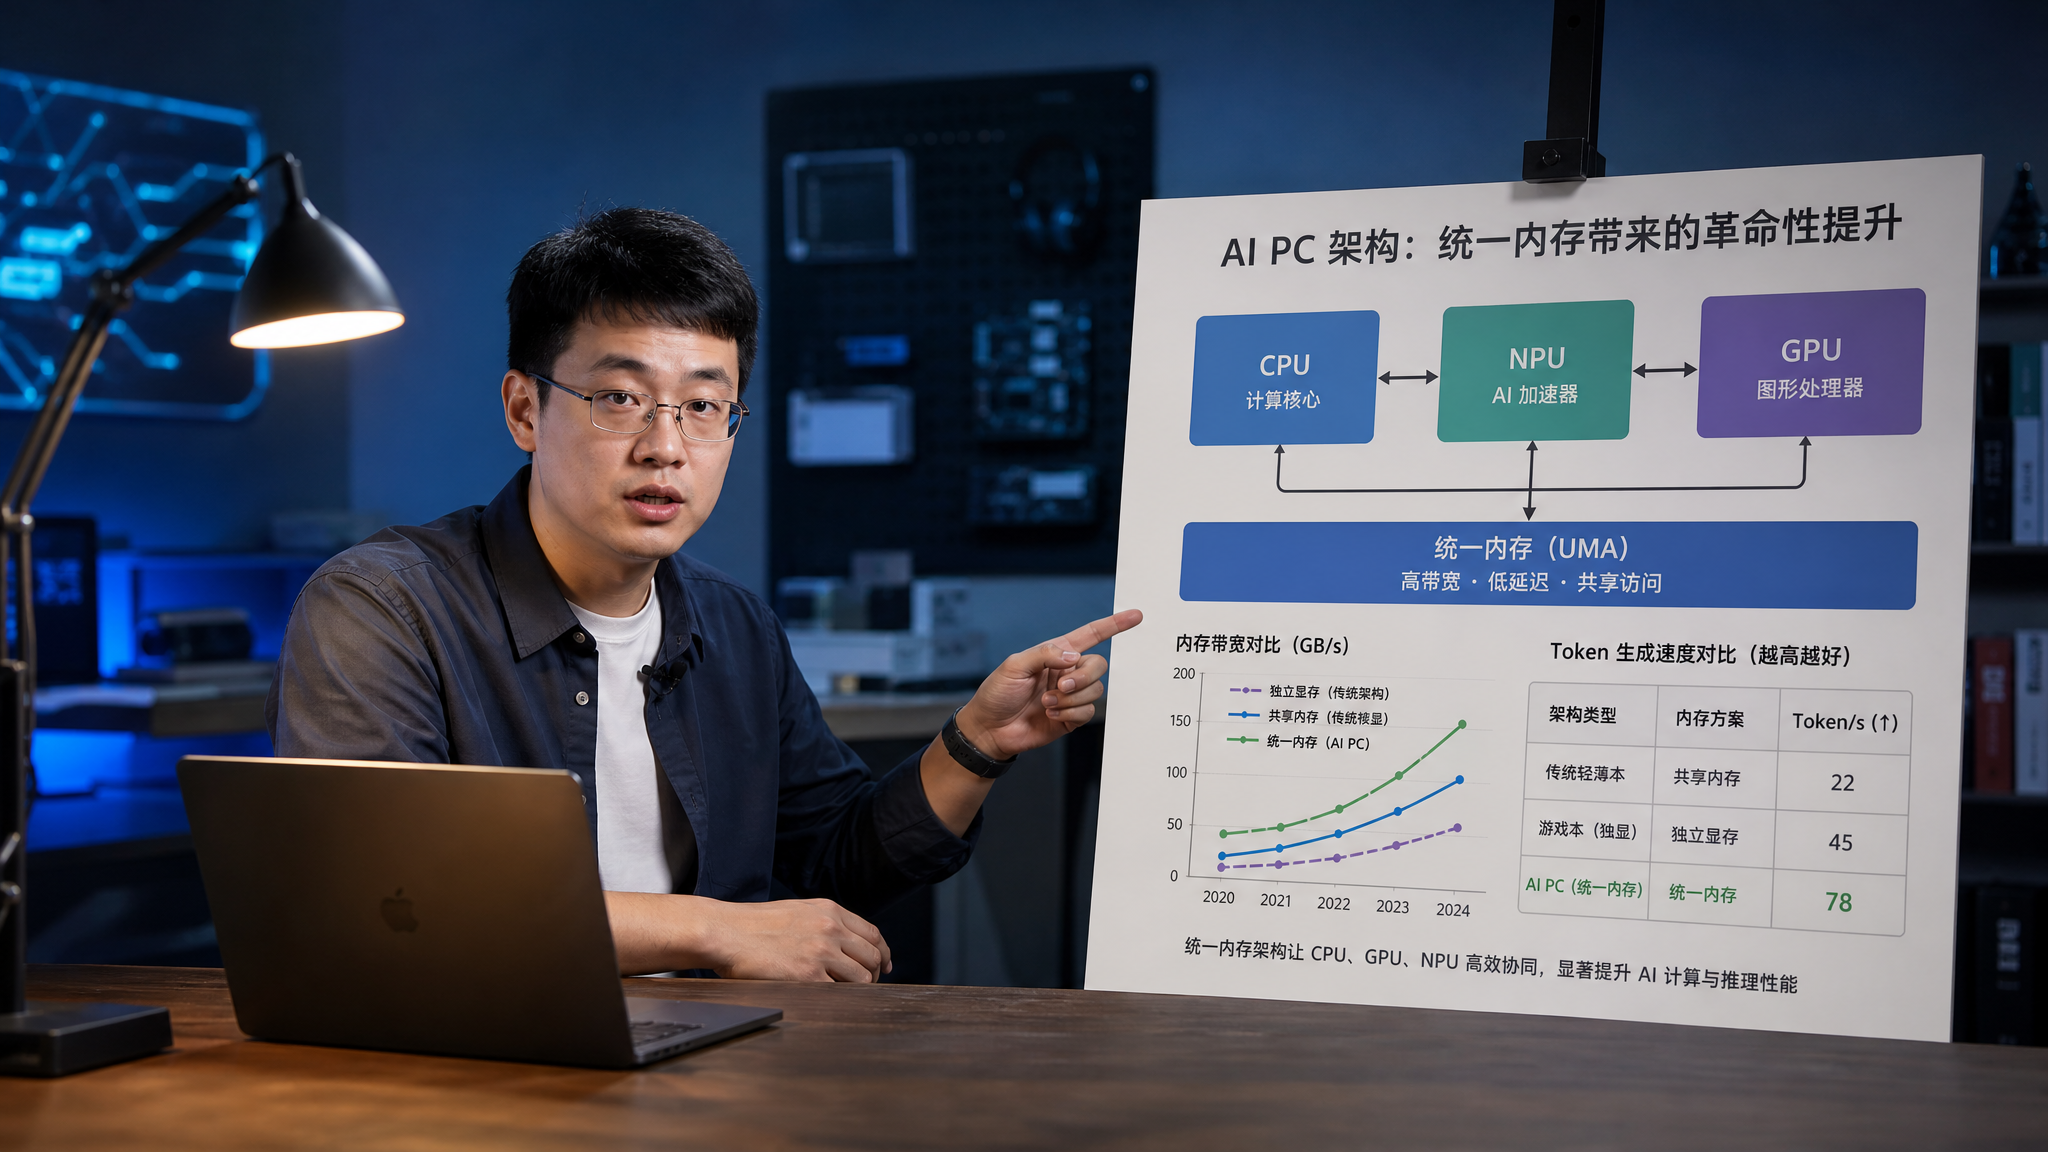
2)内存带宽:决定“吐字速度”和“首 token 延迟”
你会发现很多时候不是“每秒生成 token 少一点”,而是:
这类问题特别像带宽瓶颈:算力在那儿,但喂不饱。统一内存架构下,CPU/GPU/NPU 以及系统图形任务都在抢带宽,你买到的是整机体验,不是单一算力峰值。
3)量化格式:决定你用“省内存”换“可读性/速度/兼容性”
同一个模型,不同量化通常会直接改变:
一般来说(不写死结论,只给你判断框架):
你要的不是“最高精度”,而是“在你能接受的硬件预算下,稳定、连续、可用”。
同芯片不同内存:怎么“去水分”判断 16/32GB 及更大容量
不引用具体机型和跑分(避免你对号入座买错),用最接近真实决策的方式讲:看你的任务属于哪一类。
A 类:本地 RAG(离线知识库问答)
你会遇到两个“隐形吃内存”的地方:
1) 向量库/索引驻留(取决于规模)
2) 上下文变长(问得越深,越像在开长会)
建议思路:
关键观察点(自己测就行):
B 类:会议纪要/录音转写/摘要(偏低功耗长时间跑)
这类任务看起来轻,但很容易踩到“后台长期占用”:
建议思路:
C 类:代码补全/本地 Copilot 替代(高频、低延迟敏感)
这类最在意:
建议思路:
一句非常实用的经验:
同样的芯片,16GB→32GB 往往是“能用”到“顺手”的分水岭;32GB→更大容量 更像“从不将就”到“随便折腾”的分水岭。你买的是容错率。
端侧 AI 工作流:让 AI PC 真正变成“离线生产力”
别只把本地模型当“装了个能聊天的软件”。端侧真正好用,是把它做成系统的一部分。
1)离线知识库:把资料变成可检索的“第二大脑”
做法(原则级):
效果预期:
2)隐私文件索引:把“本地可用”这件事坐实
端侧的核心价值之一就是:敏感资料不出机器。
建议你把“可离线访问”的范围先定好,比如:
关键点不在“多”,而在“清晰”:哪些允许被索引、哪些永不索引。
3)桌面多屏协作:让 AI 参与你的窗口流
你会发现效率最高的形态通常是:
这时候机器是否“卡成 PPT”,本质就变成:内存带宽能不能扛住多任务并行。
4)夜间低功耗调度:把“生成”放到你不在线的时候
很适合的任务:
你白天要的是低延迟,晚上要的是低功耗+稳定吞吐。让 NPU 负责它擅长的事情,整机体验会更接近“有个助理在后台干活”。
选购/升级时的快速检查清单
把这四个问题想清楚,你就不会被“TOPS 数字竞赛”带着走。