这时候最容易被一句话带偏:
“你这台不行,NPU TOPS太低。”
但2026这一波 Windows AI PC(不管是新一代低功耗 x86 还是 ARM 平台)最反直觉的点恰恰是:很多卡顿不是算力不够,而是数据喂不进去、模型放不下、引擎切来切去把你坑了。
下面把“80 TOPS 仍像 PPT”的原因拆开讲清楚。
你以为NPU在跑大模型,其实它更像“常驻省电工”
先把 NPU 的定位说透:它本质是低功耗、长时在线的推理协处理单元,最擅长的不是“暴力跑超大模型”,而是:
而你本地跑 14B/更大模型时,最折磨体验的往往是 prefill(首轮读入与计算)阶段。这个阶段很多时候不是“算不动”,而是典型的带宽受限:
统一内存(比如 LPDDR5X 8533MT/s)理论带宽大约 136GB/s,和独显那种动辄上千 GB/s 的显存带宽不是一个量级。
结果就会出现:
TOPS 看着很猛,但模型的权重、激活、KV Cache 在内存里搬来搬去,搬运速度决定了你首 Token 要等多久。
决定你“体感快慢”的,其实是三层东西
把影响本地大模型体验的因素压缩成三句话:
1) 内存带宽决定上限
带宽不够,prefill 就容易拉胯。你看到的“转圈圈”,很多时候就是在等数据。
2) KV Cache 容量决定你能开多长上下文
上下文越长,KV Cache 越大,占的内存越多;一旦开始挤占系统可用内存,交换/回收一来,卡顿和掉速就会连锁发生。
3) NPU/GPU/CPU 的调度决定功耗、噪音和稳定性
Windows ML 和各家的 Execution Provider 会在 NPU 与 iGPU 之间切分算子。最致命的是:只要遇到 NPU 不支持的算子,可能直接回落到 CPU,于是性能出现“断崖式下跌”。
你听到风扇突然起飞、看到续航突然跳水,很多时候就是这种回落在作祟。
到这你会发现:TOPS 只是“峰值能力”,不是“持续体验”。
别再只看TOPS:参数去水分三件套
很多“AI PC 评测/导购”喜欢一句话总结:XX TOPS 秒杀。你要学会把水分挤掉,按这三条看:
1)先问一句:这个TOPS是“稀疏INT4峰值”吗?
不少标称 TOPS 讲的是稀疏 INT4 的峰值。但你真正跑起来,尤其涉及更通用的算子、不同精度、不同 shape,实际有效性能可能差好几倍。
所以看到 TOPS 不要激动,先把它当“实验室最好情况”。
2)内存容量与带宽,往往比TOPS更诚实
想本地“舒服”跑 14B,现实门槛很硬:
这里不是吓你,是因为模型权重 + KV Cache + 系统占用,一旦挤在一起,就很容易触发掉速。
3)看NPU支不支持混合精度与动态 shape
端侧大模型想跑得稳,很多时候需要混合精度、动态 shape 的支持。缺了这些,平台就更容易出现“某些 prompt 一跑就回落 CPU”的尴尬。
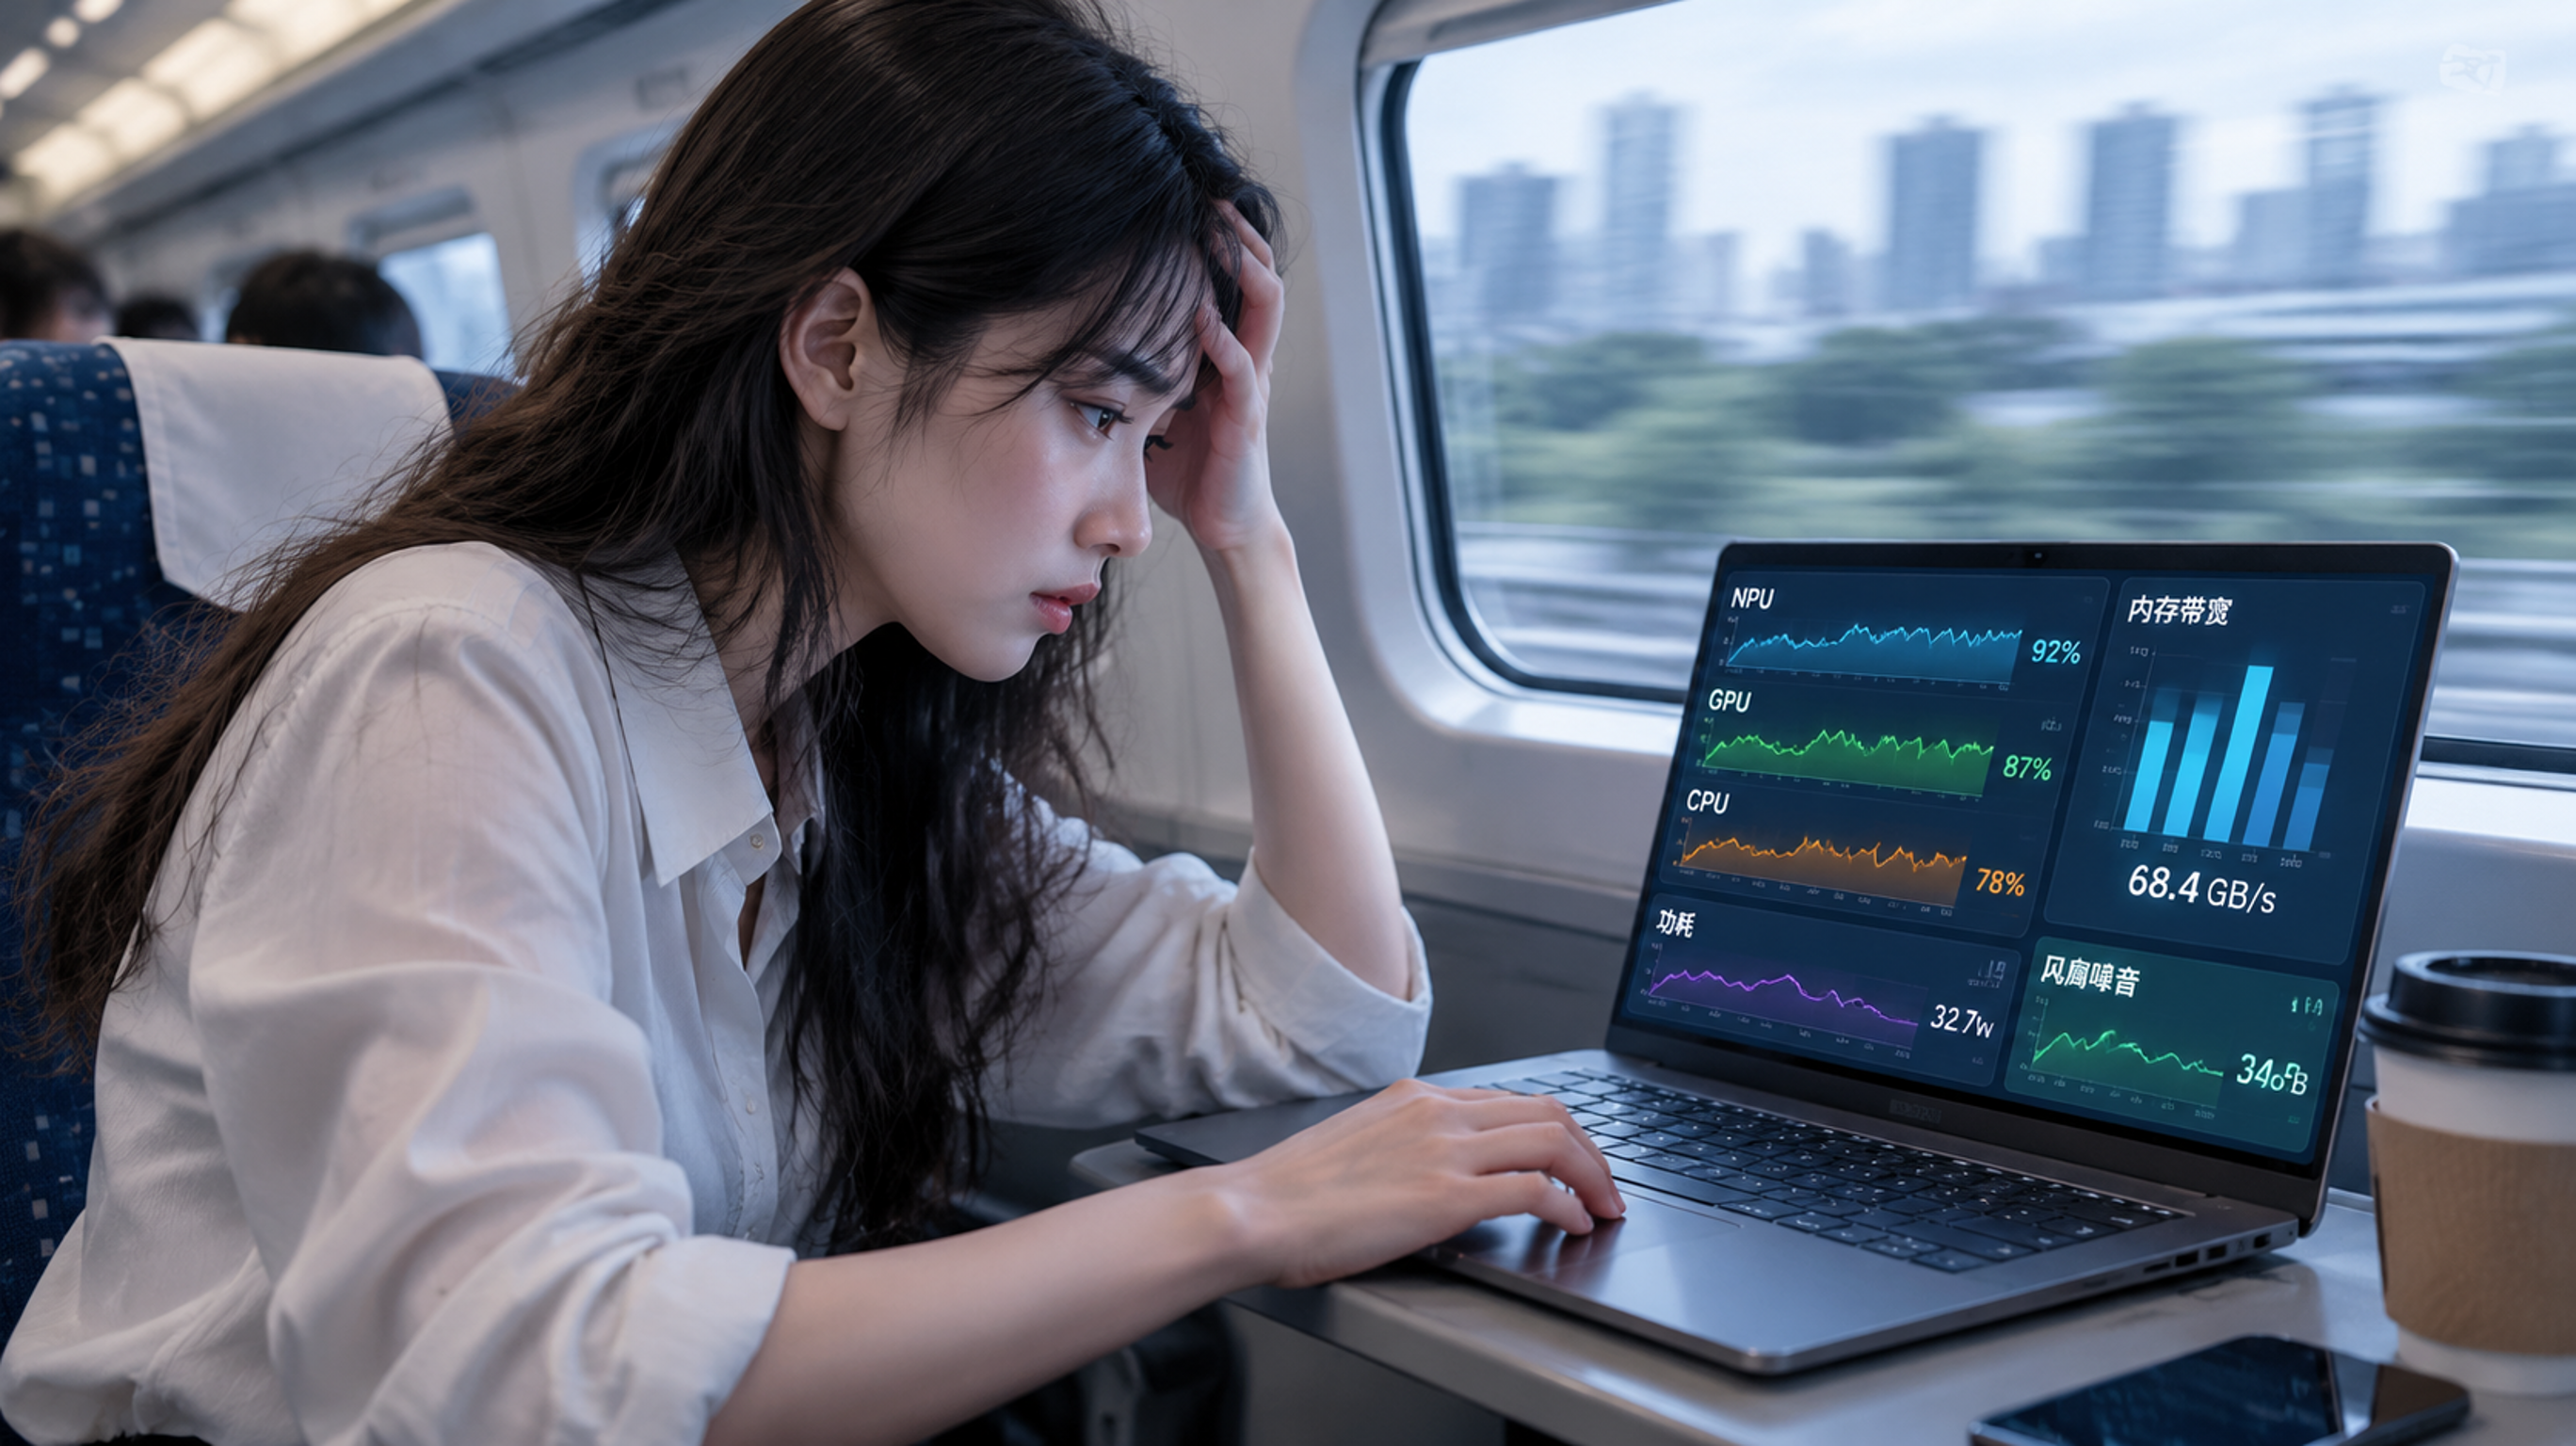
真正靠谱的评测/自测,只看4个指标
以后你刷到任何只报 TOPS、不报下面 4 项的内容,基本可以直接略过。因为这 4 个指标才是你每天体感的来源:
可复现的统一测法(你自己也能做)
尽量做到“同条件对比”,否则数据全是玄学:
你会非常直观地看到:同样 80 TOPS 的机器,体验可能完全不在一个维度。
2026年AI PC正确分工:NPU别硬扛大活
想让机器更“像 AI PC”,而不是“会发光的暖手宝”,分工要清晰:
实时字幕、会议降噪、摄像头背景虚化、唤醒词
生图、视频剪辑、需要更高带宽/并行度的工作
UI、系统调度、应用逻辑
这里还有一个很多人忽略的开关:
把电源模式设为平衡而不是高性能,往往更容易让系统把合适的负载交给 NPU,续航也可能多出 1–2 小时(尤其是常驻 AI 场景)。
两种场景的实用设置
移动办公:先让“能用”变成“好用”
桌面扩展:把带宽与IO短板补上
一句话总结这篇文章
AI PC 跑大模型的真实体验,往往由 内存带宽 + KV Cache + 三引擎调度决定;TOPS 只是宣传口径,不是你在高铁上“能不能马上出字”的答案。