关注频道 数码

刚买的 Copilot+ PC,参数表写着 45 TOPS,宣传视频里一秒出图、离线助理秒回。

作者: 月子里的那些事 发布: 2026-10-17
结果你装上本地大模型:加载半天、首句要等很久、打一会儿风扇起飞,键盘热到想垫毛巾——最难受的是,你明明想“离线提升效率”,最后却变成“离线考验耐心”。 问题往往不在“算力不够”,而在:你买到的是“能跑 AI”的 PC,不是“跑得动你要的本地大模型工作流”的 PC。 TOPS 只是入场券,真正决定体感的是三件事 很多人把 NPU TOPS 当成唯一指标,但本地大模型的“卡成 PPT”,更常 ...

结果你装上本地大模型:加载半天、首句要等很久、打一会儿风扇起飞,键盘热到想垫毛巾——最难受的是,你明明想“离线提升效率”,最后却变成“离线考验耐心”。

问题往往不在“算力不够”,而在:你买到的是“能跑 AI”的 PC,不是“跑得动你要的本地大模型工作流”的 PC。

TOPS 只是入场券,真正决定体感的是三件事

很多人把 NPU TOPS 当成唯一指标,但本地大模型的“卡成 PPT”,更常见的瓶颈是下面这三项组合拳:

1)统一内存:容量决定你能不能装得下

端侧大模型不像传统软件,“能装上”不等于“能顺畅跑”。

  • 内存小:模型只能上更狠的量化(比如 Q4),或者直接跑不动更大参数规模
  • 内存紧:系统一换后台、浏览器一多开,首 token 延迟就明显变长(你会感觉它“想很久才开口”)
  • 一句话:内存容量先决定上限,别急着谈速度。

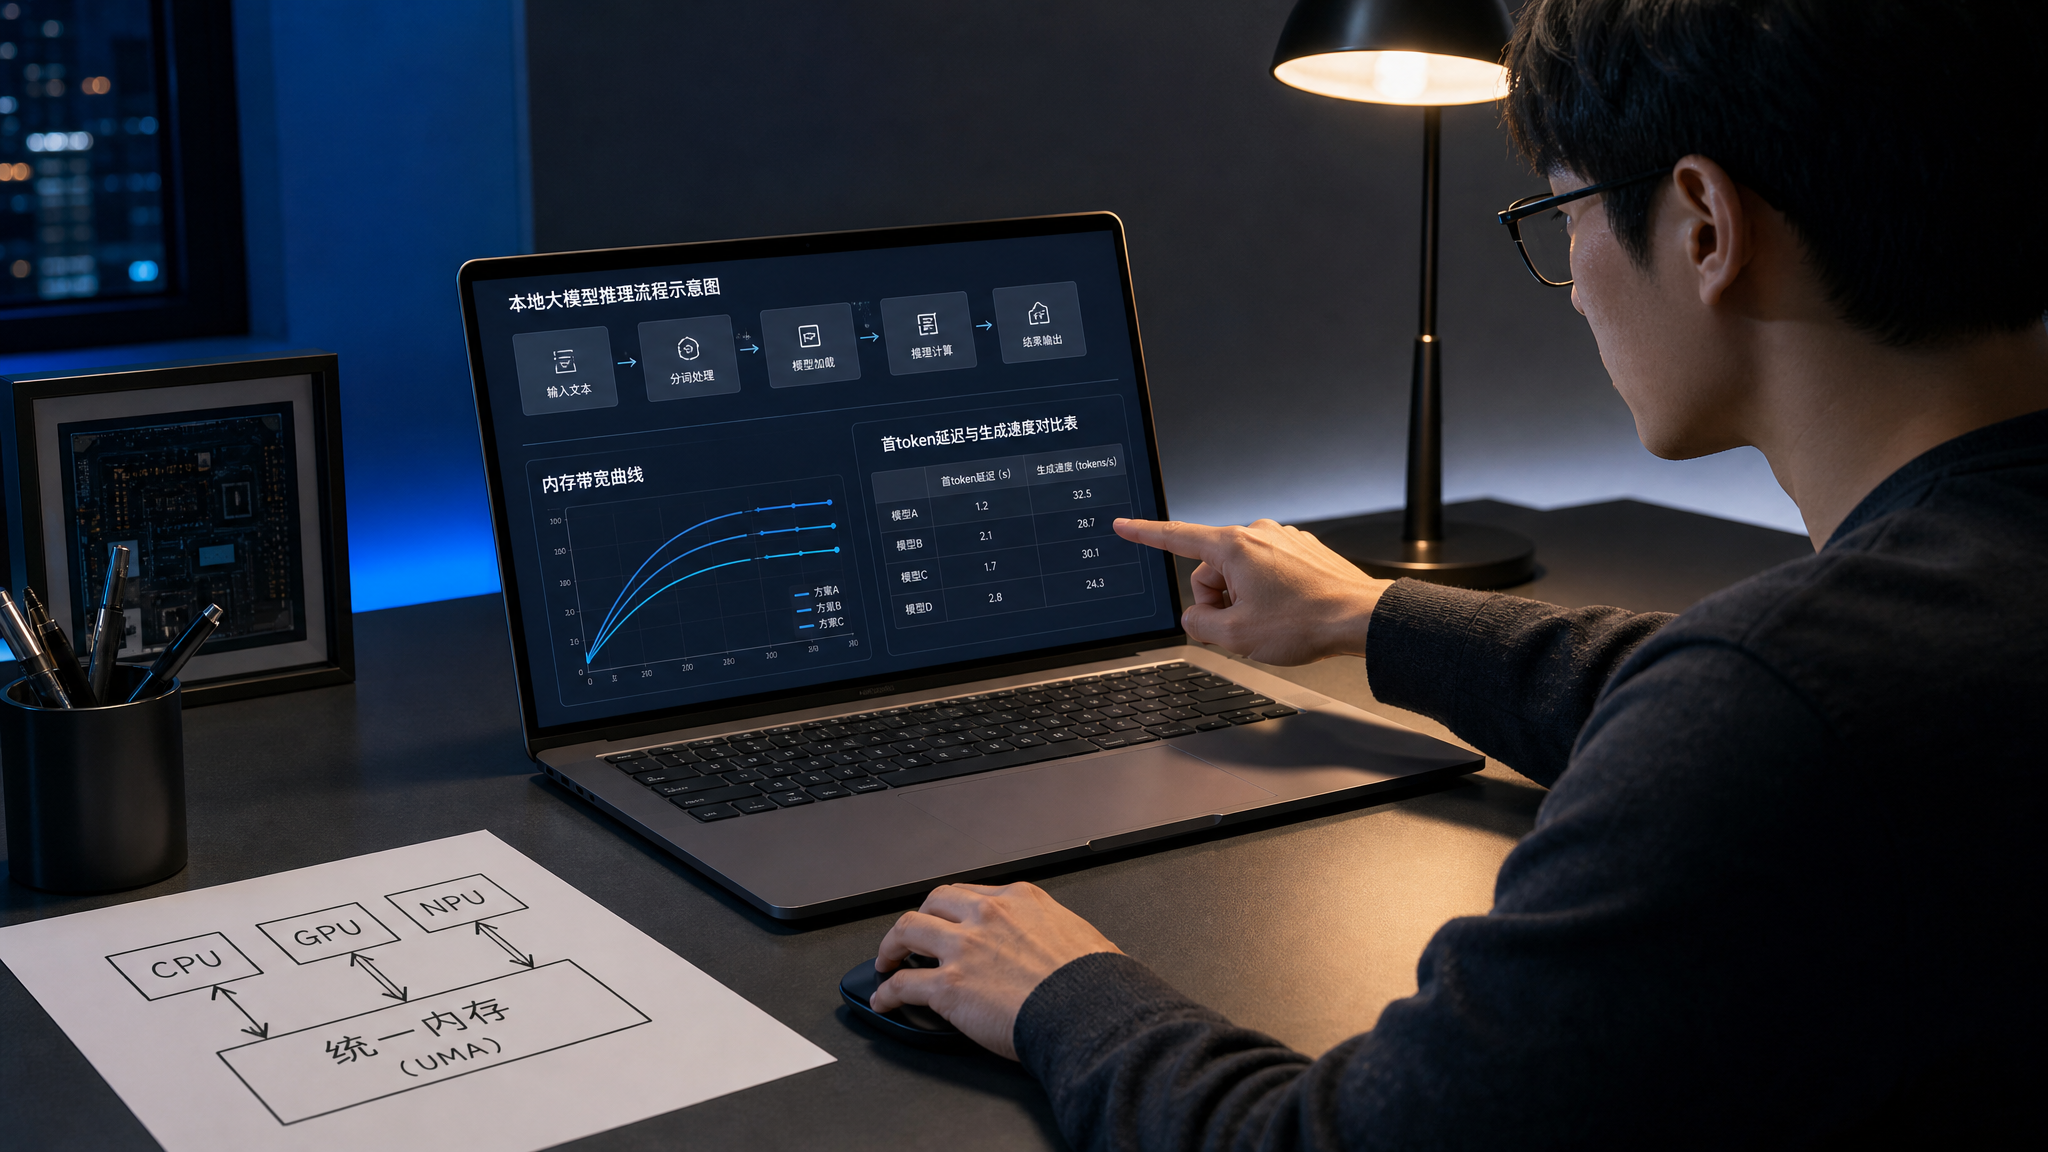
    2)内存带宽:决定你吐字快不快、稳不稳

    NPU/GPU/CPU 都要不断从内存搬数据。大模型推理很像“搬运+计算”的流水线:
    算力再强,喂不饱也会饿着等。

    你会看到一种典型现象:

  • 标称 TOPS 更高的新平台,跑起来却没比旧机器快多少
  • 甚至“开始快、后面越来越慢”,因为内存带宽被系统、图形、后台争抢
  • 因此在 2026 这波 Windows AI PC(LPDDR5X / CAMM2、统一内存、异构调度),内存带宽和内存形态对体验的影响,会比单看 TOPS 更直观。

    3)量化格式:Q4/Q8/FP16 决定“能用”还是“好用”

    别把量化当成玄学,它直接对应你每天的体感:

  • Q4:更省内存,能让“更大的模型”勉强进得来,但输出稳定性/细节可能打折
  • Q8:更接近“可长期写作/总结”的平衡点,常见任务更稳
  • FP16:质量更好,但对内存容量与带宽要求更高,稍配不对就变“加载慢+发热大”
  • 所以“本地大模型卡”,很多时候不是芯片差,而是:你的内存容量/带宽与所选量化不匹配。

    同芯片 16/32GB 与更高内存:怎么选才不交智商税

    不虚构跑分,也不硬塞结论,用最接近日常的三类任务来做“配置去水分”。

    16GB:适合“轻量 AI 功能”和短任务

    如果你的主要需求是:

  • 系统级小功能(转写、简单润色、轻量问答)
  • 偶尔本地跑小模型、短文本
  • 不做长期离线知识库、不做大规模文档索引
  • 16GB 勉强可以,但你要接受:模型选择空间很小,且多开应用时体验波动明显。

    32GB:端侧生产力的“合理起点”

    如果你想把 AI 变成“每天都会用”的工具:

  • 会议纪要:长音频转写 + 结构化总结
  • 本地 RAG:几十到几百份文档的离线检索问答
  • 代码补全:项目级上下文 + IDE 常驻
  • 32GB 通常是更舒服的起步配置:

  • 量化选择更自由(从“能跑”变成“能长期跑”)
  • 多任务时的首 token 延迟更稳定
  • 你会明显感觉:AI 不再是“演示功能”,而是“可以挂后台的助手”。

    更大内存:为“大模型常驻 + 大上下文 + 多应用并行”买单

    更大内存不是给“偶尔试试”的人准备的,它更适合:

  • 你希望更高质量的量化(比如从 Q4 升到 Q8,甚至尝试更高精度)
  • 你有更大的离线知识库、更多隐私文件索引
  • 你希望模型常驻、浏览器几十标签 + IDE + 文档 + 会议同时开,还要稳定吐字
  • 它带来的不是“单次快一点”,而是:你开始敢把 AI 当作全天候工作流的一环,不用每次先关一堆软件给它腾内存。

    你真正该看的是这张“体感指标清单”

    别被参数页绕晕,选 AI PC 时,把问题问成这几句更有效:

  • 我常用的模型量化是什么(Q4/Q8/FP16)?目标模型能不能常驻?
  • 同时开浏览器+Office/剪辑/IDE 时,首 token 延迟会不会飙?
  • 内存形态与带宽是否足够喂饱 CPU/GPU/NPU 的协同调度?
  • 散热与功耗策略是否允许“夜间低功耗常驻任务”?(比如离线索引、批量总结)
  • 你会发现:这些问题的答案,往往比“TOPS 大不大”更接近真实体验。

    未来感办公桌场景,一位中国年轻工程师坐在桌前操作一台笔记本电脑,屏幕上显示“本地大模型推理流程示意图

    一套能落地的端侧 AI 工作流:让“离线”真的省时间

    把 AI PC 用起来,不是装个模型就完了,关键是流程设计。下面这套适合移动办公/极客桌面:

    1)离线知识库:先分层,再索引

  • 热知识:你经常用的资料(规范、模板、项目文档)放在“热库”
  • 冷知识:历史资料、归档文件放“冷库”
  • 先从热库做 RAG,效果和速度最容易立竿见影
  • 这样做的好处是:索引更轻、检索更稳、更新成本更低。

    2)隐私文件索引:把“权限边界”设计进流程

    端侧的价值之一是隐私。建议你把文件按敏感级别分目录:

  • 工作敏感(合同、报价、客户信息)
  • 个人隐私(证件、财务)
  • 可公开资料(公开文档、学习资料)
  • 索引时只给模型它需要的那层,避免“为了方便全盘喂进去”。

    3)桌面协作:让 CPU/GPU/NPU 各干各的

    你不需要懂太多架构,但可以用“任务分配”的思路减少互相抢资源:

  • 文档/浏览器/会议软件:保持轻量
  • 推理任务:尽量固定一个窗口/一个会话
  • 需要图形加速的工作(比如图像处理):避免与大模型推理同时满载
  • 体感上最明显的收益是:吐字更稳、风扇更少起飞。

    4)夜间低功耗调度:把“重活”交给睡觉时间

    适合夜间跑的任务:

  • 批量转写与纪要生成
  • 文档索引更新
  • 项目资料整理与标签化
  • 第二天你打开电脑,不是从“开始跑”开始,而是直接进入“开始用”。